从 755GB 到 395GB:Bitdeer AI 如何将 GLM-5.3 的 GPU 显存占用减半
作者:Dang Hoang Duy
TL;DR
GLM-5.3 拥有 7,530 亿参数,以 FP8 格式发布时权重体积达 755 GB,对于拥有 640 GB 显存的 8xH100 节点而言体积过于庞大,特别是在还需要为 KV 缓存预留空间的情况下。我们在内部将其量化为 W4AFP8(4-bit 专家,FP8 激活):量化后的 Checkpoint 约为 395 GB,只需单个节点即可提供服务,而非两个节点;并且在所有有对比数据的基准测试中,其表现均与未量化的原模型保持一致。我们构建了 AWQ 和专家并行 GPTQ 两条流水线,并推荐使用后者:它将单 GPU 校准显存占用从约 76 GB 降低至 10 GB 以下,生成 Checkpoint 的耗时减少了约 37%,且能以少 5.5%–18.2% 的输出 Token 数量达到相同的回答质量。
本文目录:
• 我们量化了什么
• 难点在于显存限制
• 回答质量是否依然准确?
• 分数相同,Token 更加精简
• 部署指南
GLM-5.3 体量巨大。其 7,530 亿参数以 755 GB 的 FP8 权重形式分布在 141 个文件中,而一个 8xH100 节点仅拥有 640 GB 的 GPU 显存。权重本身就无法装下,更不用说为用于保存所有并发请求状态的 KV 缓存预留空间了。
因此,我们对模型进行了自行量化,将其压低至 4-bit 专家权重与 FP8 激活值。最终得到的 Checkpoint 约为 395 GB,可在单节点上运行部署。在所有有参考对比数据的基准测试中,它都达到了与未量化模型相当的水平。
除非另有说明,本文中的所有数据均在搭载 8 张 NVIDIA H100-80GB GPU 的节点上测得。若要以完整的 1M 上下文长度部署 GLM-5.3,我们建议使用 8xH200 节点。
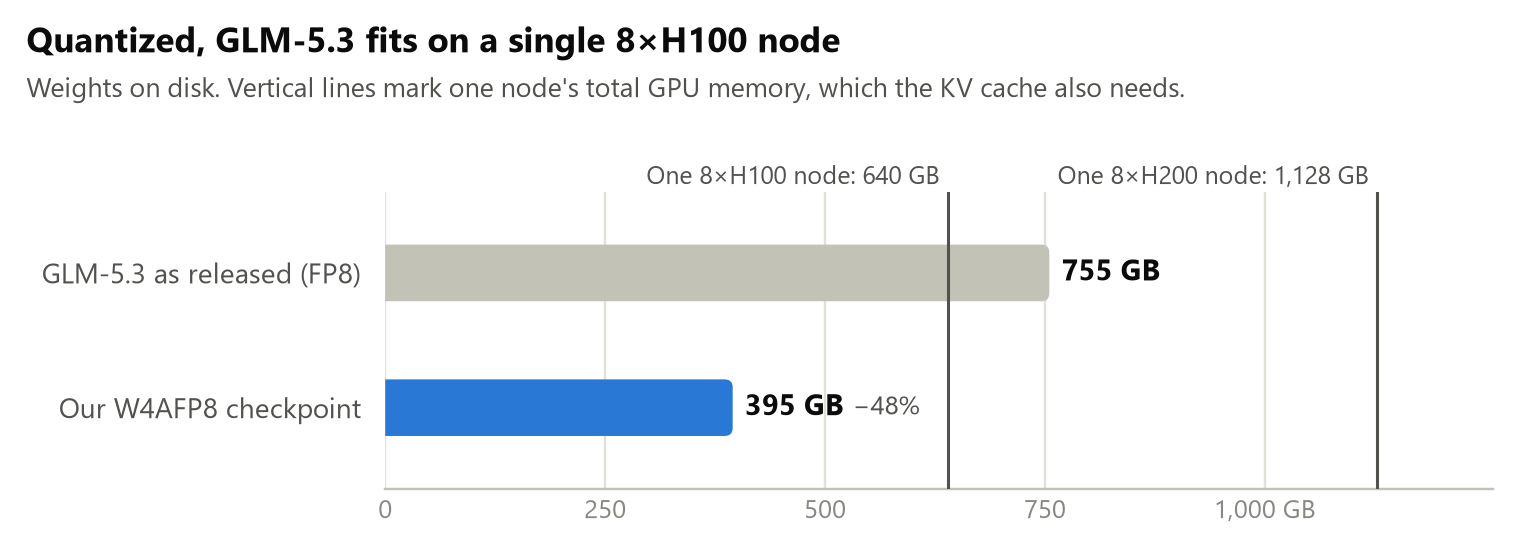
图 1. 权重体积与单 8-GPU 节点容量对比。位于垂直线左侧的方案仍需与 KV 缓存共享该节点的显存。
我们量化了什么
W4AFP8 代表 4-bit 整数权重与 8-bit 浮点激活值,但我们并没有将其应用到所有模块。GLM-5.3 的 75 个 MoE 层中,每层都包含 256 个路由专家(Routed Experts),它们占据了模型绝大部分的参数。这正是使用 4-bit 带来最高收益的地方,因此我们在这些专家模块上采用了 INT4。其余组件要么体积过小无足轻重,要么过于敏感不宜改动。
这一划分方式并非由我们随意设定,而是完全符合 SGLang 的 w4afp8 路径要求,甚至细致到了 DSA(稀疏注意力)索引器——该推理引擎拒绝以 BF16 格式加载该模块。如果格式布局出现偏差,就意味着在模型能够正常部署前,需要对这 400 GB 的数据重新进行一次转换 Pass。因此,我们的两条流水线都会直接输出符合 SGLang 规范的布局(包含 MTP 草稿层)。
难点在于显存限制
我们构建了两种量化路径。AWQ 通过在量化前对显性权重通道(即对应最大激活值的通道)进行缩放保护。GPTQ 则是按列逐一量化,并利用二阶信息来补偿未量化权重的误差。两者使用了相同的校准数据集:来自 UltraChat 的 256 个样本(每个样本 2,048 个 Token),且对每一层的所有 256 个专家均进行了校准。由于 BF16 原始权重高达 1.51 TB,而单节点仅有 640 GB 显存,两套路径都必须逐层(以解密器层为单位)进行校准。
GPTQ 在显存开销上的瓶颈尤为突出。对于量化的每个线性模块,它都需要根据该模块的校准输入维护一个 Hessian 矩阵。GLM-5.3 的单个 MoE 层就拥有 768 个这样的模块(256 个专家,每个专家 3 个投影矩阵),在标准的同行数据并行实现中,每张 GPU 都需要在合并前累加所有矩阵。这导致在加载任何权重或激活值之前,单张 80 GB 显卡上就已经产生了约 76 GiB 的工作显存开销。按照原有方式,GPTQ 根本无法在此模型上运行。
解决方案是用专家并行(Expert Parallelism)替代数据并行。IST-DASLab 的 MoE-Quant 在 DeepSeek-V3 上出于同样的原因采用了相同的做法。每张 GPU 只负责一部分专家的子集,并仅保存这部分专家的 Hessian 矩阵。校准激活值会预先进行 All-Gather 汇总,因此每张 GPU 都会在所有 Token 上运行其对应的专家,确保每个 Hessian 矩阵依然覆盖完整的校准集。在 4 卡和 8 卡上运行时的峰值显存分别仅为 26.3 GB 和 13.6 GB。两次运行得出了完全一致的贪婪输出(Greedy Output),证明任务切分方式并不会改变最终结果。此外,在相同硬件下,该路径生成 Checkpoint 的墙上时钟耗时比 AWQ 减少了约 37%。
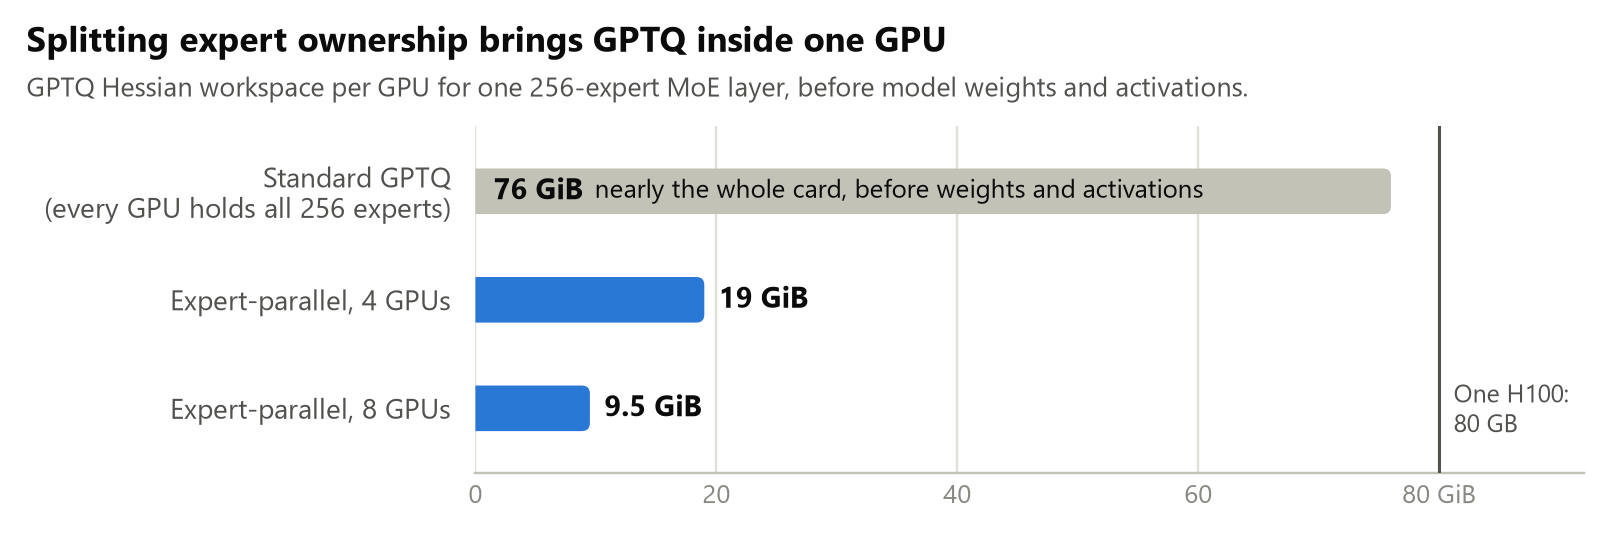
图 2. 在 H100-80GB 显卡上,单个 MoE 层中单 GPU 所需的 Hessian 工作区显存。
回答质量是否依然准确?
为了验证这一点,我们对同一模型的三个 W4AFP8 Checkpoint 进行了评估比较:我们的专家并行 GPTQ 版本、我们的 AWQ 版本,以及 PhalaCloud 独立发布的 W4AFP8 版本。评估使用相同的测试框架和 Prompt,仅权重不同。我们遵循 Artificial Analysis 的 公开测试方法 复现了两个基准测试:GPQA Diamond(198 道题目,重复测试 5 次)以及长上下文推理基准 AA-LCR v1.1(100 道题目,重复测试 3 次,每道题输入约 9.7 万个 Token)。
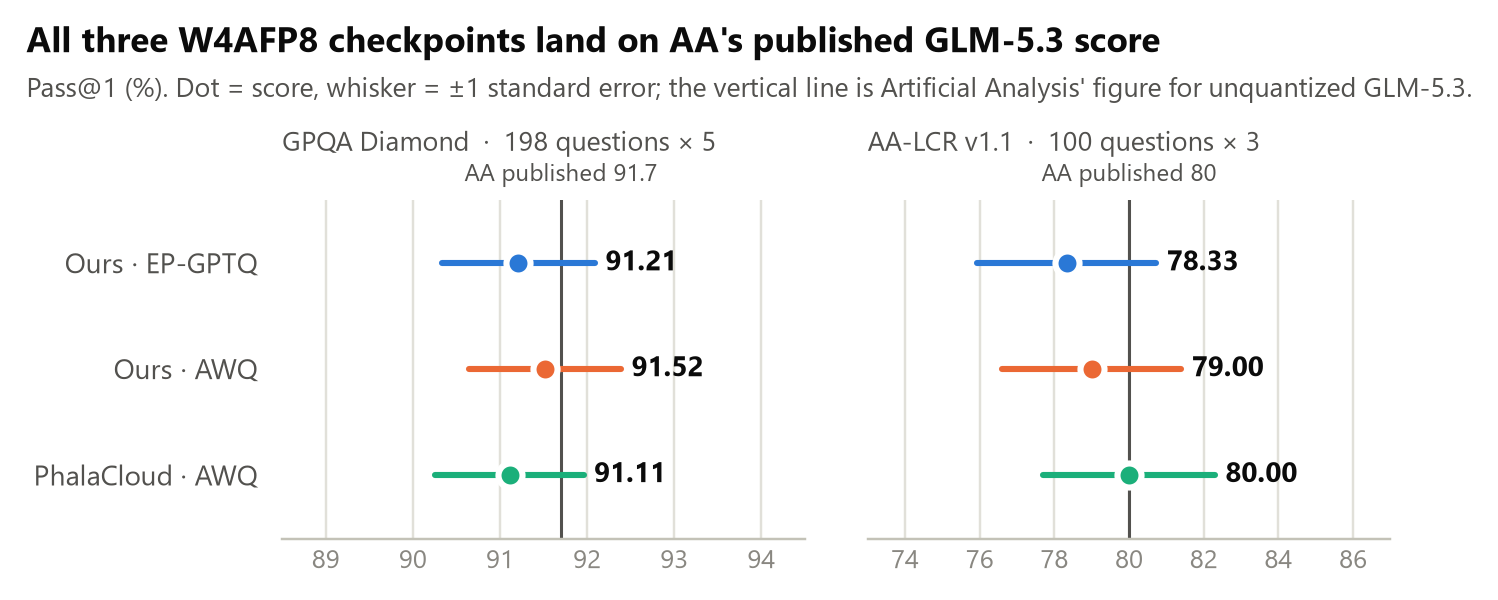
图 3. 须线代表标准误差(1 个标准差)。垂直线表示 Artificial Analysis 公布的未量化 GLM-5.3 得分。
基于我们自建端点、按照公开测试方法复现的结果,非 Artificial Analysis 官方运行数据。PhalaCloud 的官方 Card 在不同协议下报告的数据为 91.9 和 73.0。
三者的表现几乎没有差别。在 GPQA Diamond 上,表现最好与最差的 Checkpoint 相差仅 0.41 个百分点,而误差带约在 +/-0.9 左右。在 AA-LCR 上,三者回答了相同的 300 道测试题,我们通过配对检验(Paired Test)对各组进行了直接对比,组间无显著差异(p 值为 0.55 到 0.87)。
在涵盖 6 项任务的综合能力测试套件中(使用 lm-evaluation-harness 在全量测试集上评估),也得出了相同的结论。
在任何任务上,任意两个 Checkpoint 之间的差距均未超过 2 分。差距最大的是 IFEval(1.85 分),但在当前样本量下,这完全处于测量噪声范围内。
我们还运行了 Terminal-Bench,用以测试模型在命令行环境中完成实际任务的能力。本次测试中,我们同时将未量化的 GLM-5.3 作为基准进行对比,这也是本文中唯一将量化 Checkpoint 与原始模型直接对比的测试项。
与上述基准分开运行。得分是 3 个随机种子的均值,这里的 +/- 表示跨种子的标准差(而非其他表格中的标准误差)。由于 Terminal-Bench 规模较大,我们仅测试了 3 个种子;在此类高方差下,3 种子的标准差仅能作为粗略参考。我们的 AWQ Checkpoint 追平了未量化原版模型的均值;而 PhalaCloud 3.0 分的差距也小于其自身的数据波动范围。
分数相同,Token 更加精简
因此,基准得分并不能拉开这三个 Checkpoint 的差距,真正拉开差距的是它们得出答案所需的输出长度。我们的 EP-GPTQ 版本能够以更短的思维链达到相同的正确率。在 GPQA Diamond 上,它生成的单题平均输出 Token 比我们的 AWQ 版本少 5.5%,比 PhalaCloud 少 14.6%。在 AA-LCR 上,这一差距分别扩大到 18.2%(对比自研 AWQ)和 8.0%(对比 PhalaCloud)。
在 API 线上服务中,输出 Token 数量直接决定成本,因此这意味着直接的费用节省。不过,节省幅度取决于实际工作负载:在短文本回答测试集中,这一差异并不明显。
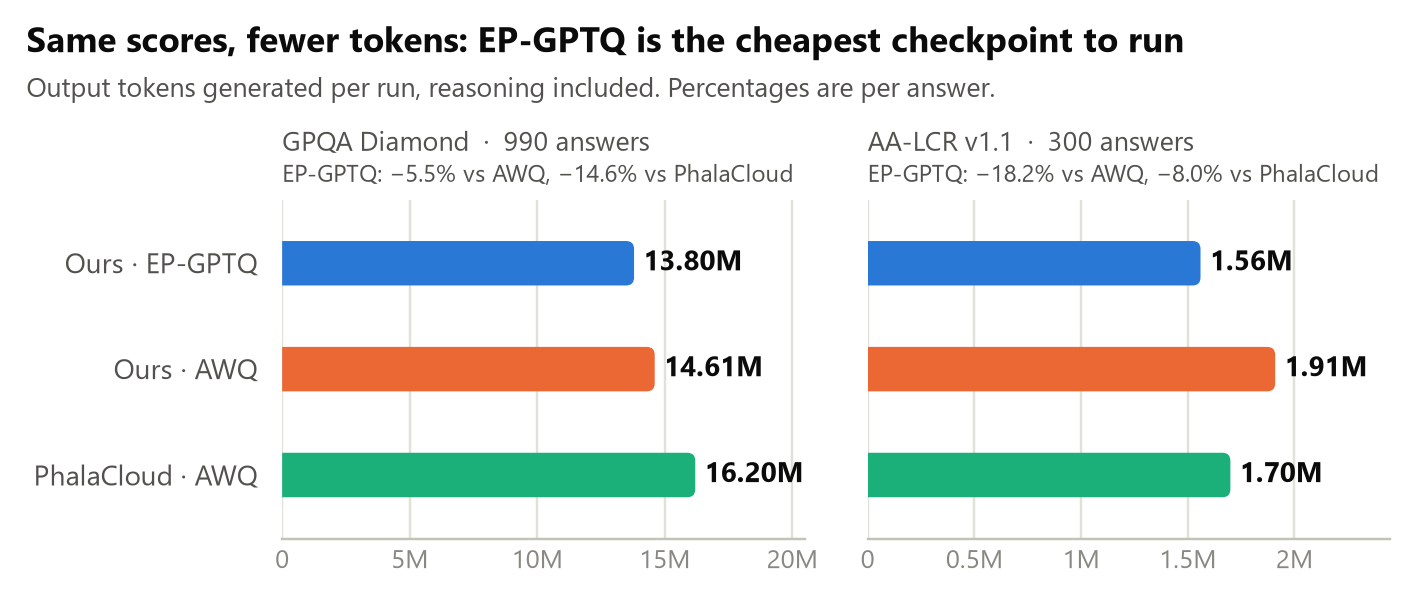
图 4. 准确率相同情况下的运行总 Token 消耗。上述百分比代表单个回答的平均降幅。
部署指南
两个 Checkpoint 均已开源至 Hugging Face 的 Bitdeer AI 账号下,且运行方式一致,可按需选择。
部署需准备 SGLang 0.5.17 或更新版本、一台搭载 8 张 GPU 的 Hopper 节点,以及约 400 GB 的可用磁盘空间。
发送请求时请将 temperature 设置为 1.0,top_p 设置为 0.95(此为 Model Card 推荐设置)。两个 Checkpoint 在保存时均已重新集成了原始发布的 MTP 草稿层,因此无需额外挂载草稿模型即可直接启用 EAGLE 投机解码。添加 --speculative-algorithm EAGLE 参数即可开启。每个 Model Card 中均附有完整的启动 Flag 说明,包括针对不同节点需要调整的上下文长度与显存比例设置。
我们在 SGLang 0.5.17 环境下,使用张量并行 8(TP 8)及 FP8 KV 缓存完成了此配置的验证。量化后的 Checkpoint 继承 GLM-5.3 原始开源许可证。
总结
- 7,530 亿参数:FP8 权重 755 GB,W4AFP8 量化后降至约 395 GB,节点需求从 2 个减少至 1 个。
- 无损质量:在两个核心基准测试上均追平了 Artificial Analysis 公布的 GLM-5.3 成绩,并与第三方 W4AFP8 发布版本保持同一水准。
- Terminal-Bench 实测:在该项与未量化 GLM-5.3 原模型对比的测试中,我们的 AWQ Checkpoint 在 3 个随机种子下的平均分达到了 85.4%,完全追平原模型。
- 专家并行 GPTQ:在不改变模型回答结果的前提下,将 256-专家层所需的单 GPU 校准显存从约 76 GiB 大幅缩减至 10 GiB 以下。
对超大规模 MoE 模型进行压缩,并不意味着要牺牲模型精度或硬件效率。通过专家并行 GPTQ,我们验证了 GLM-5.3 完全可以塞进单台 8xH100 节点中,同时保持不打折的评估分数,并生成明显更少、更精简的推理 Token。
两款 Checkpoint 均已上架 Hugging Face。鉴于推理成本更低,我们首推专家并行 GPTQ 版本。欢迎获取上述命令启动您的单节点实例,并在生产环境中进行实测体验!